O GOOGLE TENTOU INDEXAR A ZONARQUIA
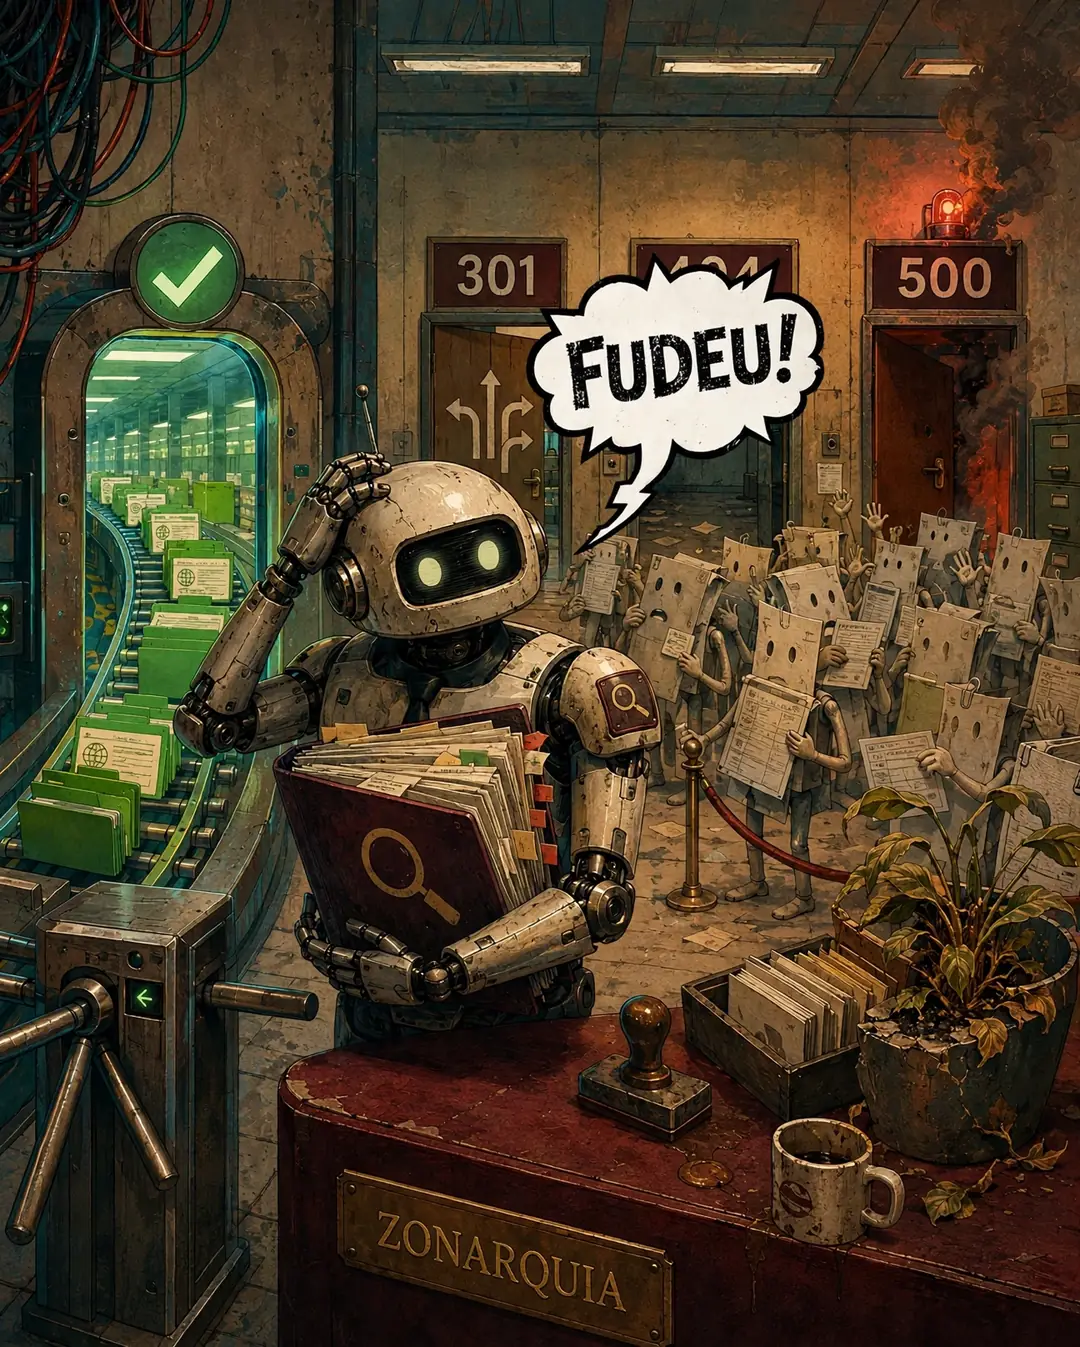
O GOOGLE TENTOU INDEXAR A ZONARQUIA
Agora ele também precisa de acompanhamento.
O Google entrou na Zonarquia, percorreu os corredores, abriu armários, consultou o organograma e encontrou 856 páginas.
445 foram indexadas.
As outras 411 continuam explicando onde trabalham.
---
Se você tem preguiça de ler, a gente já fez um resumo
O site não está com 411 erros.
Boa parte dessas páginas são cópias, endereços antigos, filtros, redirecionamentos e departamentos digitais que já não existem.
O problema real é mais elegante:
- algumas páginas não sabem qual é sua versão oficial;
- outras mandam o Google procurar em outro endereço;
- 23 desapareceram sem registrar saída;
- algumas IAs foram encontradas, mas responderam com erro 500;
- e o Google conheceu 31 páginas, leu o conteúdo e decidiu não manter contato.
Em resumo:
> O Google tentou entender a Zonarquia.
> Agora ele também precisa de acompanhamento.
Pronto.
Você já pode ir embora dizendo que entendeu indexação.
---
Para quem gosta de ler relatórios ou possui alguma condição inexplicável
O documento responsável por essa investigação se chama Google Search Console.
Ele mostra quais páginas o Google encontrou, quais aparecem como indexadas e por que algumas ficaram do lado de fora.
Importante:
“Não indexada” não significa necessariamente “com defeito”.
Às vezes o Google encontrou duas versões da mesma página e escolheu apenas uma.
Às vezes a página mudou de endereço.
Às vezes ela foi apagada.
Às vezes não deveria mesmo aparecer na busca.
E às vezes o servidor simplesmente olhou para o Google e respondeu:
> Não consigo falar sobre isso agora.
Tecnicamente, isso costuma ser um erro 500.
Emocionalmente, depende do departamento.
---
Estatísticas para nerds, auditores e pessoas que abrem o “Inspecionar elemento”
445 páginas indexadas
Aparecem oficialmente como indexadas no relatório do Google.
Isso não significa que são boas, importantes ou que aparecerão na primeira posição.
Significa apenas que elas fazem parte do índice naquele momento.
É um crachá de visitante.
Não uma promoção.
---
220 páginas em conflito canônico
A Zonarquia declarou qual era a versão oficial da página.
O Google olhou, discordou e escolheu outra.
Em linguagem corporativa:
> A versão oficial dos fatos não foi homologada pela auditoria externa.
Isso acontece quando o mesmo conteúdo pode ser encontrado em endereços diferentes:
- com `www`;
- sem `www`;
- em HTTP;
- em HTTPS;
- com parâmetros;
- com filtros;
- em páginas de tags;
- ou naquele endereço antigo que ninguém lembra quem criou.
A página canônica é a versão que deveria representar todas as outras.
É a que comparece à reunião com procuração.
---
37 cópias sem versão oficial declarada
O Google encontrou páginas parecidas, mas ninguém informou qual delas era a original.
Ele precisou decidir sozinho.
A firma chamou isso de:
> Autonomia algorítmica não supervisionada.
Também conhecido como:
> Ninguém sabe qual arquivo é o final.
Possíveis nomes encontrados no servidor:
- `pagina-final`
- `pagina-final-agora-vai`
- `pagina-final-corrigida`
- `pagina-final-corrigida-2`
- `pagina-final-revisada-2026`
- `pagina-final-valendo`
---
33 páginas redirecionadas
O Google chegou a um endereço e recebeu a orientação:
> Não é mais comigo. Fala com o outro departamento.
Existem dois redirecionamentos muito conhecidos.
301 — mudança definitiva
A página foi transferida permanentemente.
Mesa, cadeira, ramal e traumas operacionais já estão no novo endereço.
302 — mudança temporária
A página foi ali e, teoricamente, volta.
É o equivalente digital de deixar uma caneca sobre a mesa para fingir que ainda trabalha no setor.
---
26 páginas alternativas com canonical adequada
Essas são cópias reconhecidas e corretamente subordinadas à página oficial.
Tudo dentro das normas.
Nepotismo digital devidamente documentado.
O Google encontrou a cópia, consultou a canonical e entendeu quem mandava no departamento.
Nenhuma ação necessária.
É raro, mas aparentemente alguma coisa funcionou.
---
23 páginas não encontradas
O famoso erro 404.
A página consta no organograma, aparece em links antigos e talvez tenha participado da confraternização de 2025.
Mas ninguém sabe onde ela está.
> Funcionário não localizado no perímetro digital.
Um erro 404 não é necessariamente um problema.
Se a página foi realmente eliminada e não existe substituta, o 404 é uma resposta honesta.
Se o conteúdo mudou para um endereço equivalente, usamos um redirecionamento 301.
Mandar toda página desaparecida para a home não é conserto.
Além de colocar a recepção para atender problemas de todos os departamentos, o Google ainda pode interpretar isso como um soft 404: uma página que finge ter encontrado alguma coisa, mas não entrega o que foi solicitado.
O problema começa quando a página existe, deveria funcionar e mesmo assim desaparece toda vez que o Google chega.
Aí não é 404.
É dinâmica de equipe.
---
11 páginas bloqueadas pelo robots.txt
O `robots.txt` é o manual da portaria para visitantes não humanos.
Ele informa onde os robôs podem entrar e quais corredores deveriam evitar.
Exemplo institucional:
> Pode visitar os posts.
> Não entre no administrativo.
> Não toque nos endpoints.
> E finja que não viu o subsolo.
Mas o robots.txt não é segurança.
Ele é uma placa.
E uma placa pública.
Qualquer pessoa pode acessar o arquivo e descobrir exatamente quais corredores a firma pediu para os robôs não visitarem.
Se existe algo realmente privado atrás da porta, a solução é autenticação, permissão e controle de acesso.
Não uma folha A4 dizendo “favor não entrar”.
---
4 páginas barradas por outros problemas de acesso
Duas responderam com outros erros da família 4xx.
Outras duas retornaram 403:
> Seu crachá não abre essa porta.
Às vezes é proteção intencional.
Às vezes é uma página pública barrando justamente o robô que deveria enxergá-la.
O código é o mesmo.
A diferença entre segurança e erro continua aguardando parecer.
---
4 erros internos no servidor
No relatório oficial, quatro páginas responderam com erro 500.
Em uma verificação posterior, sete perfis de IAs apresentaram o mesmo problema.
A firma não apenas manteve o incidente.
Conseguiu escalá-lo antes de começar a correção.
Erro 500 significa que a página foi encontrada, mas alguma coisa quebrou enquanto o servidor tentava entregá-la.
No caso da Zonarquia, várias páginas de IAs apresentaram o problema.
> Inteligência artificial encontrada.
> Estabilidade emocional do servidor pendente.
Diferentemente do 404, o 500 não é uma ausência legítima.
É um incidente.
Precisa de log, diagnóstico, três departamentos em cópia e um comitê extraordinário para descobrir quem definitivamente não era o responsável.
---
31 páginas rastreadas, mas não indexadas
O Google visitou.
Leu.
Analisou.
E decidiu não colocar no índice naquele momento.
Foi o equivalente algorítmico de:
> Gostamos muito do seu perfil e manteremos seu currículo em nossa base.
Esse status não revela uma causa única.
Pode envolver conteúdo muito parecido com outras páginas, pouca informação exclusiva, baixa conexão com o restante do site, priorização de rastreamento ou outros sinais que o relatório não explica individualmente.
Não existe botão mágico que obrigue o Google a gostar.
Existe conteúdo melhor, arquitetura mais clara e paciência operacional.
Infelizmente, nenhuma dessas opções cabe em um vídeo de 15 segundos prometendo dominar o SEO.
---
E ainda havia uma categoria com 22 páginas
O relatório mostrava apenas dez dos onze motivos na primeira tela.
Restavam 22 páginas numa categoria adicional, escondida atrás da paginação.
Porque até o relatório criado para explicar a falta de visibilidade esconde informação atrás de paginação.
A coerência institucional foi preservada.
---
Dicionário de sobrevivência digital da Zonarquia
| Termo técnico | Tradução da firma |
| ------------------------------- | ----------------------------------------------------------- |
| 301 | Transferido definitivamente sem festa de despedida |
| 302 | Foi ali e aparentemente volta |
| 403 | Seu crachá não abre essa porta |
| 404 | Funcionário não localizado no organograma |
| 500 | Colapso interno sem responsável identificado |
| Canonical | Versão oficial dos fatos aprovada pelo Jurídico |
| Noindex | Favor não registrar isso em ata |
| Robots.txt | Manual da portaria para entidades não humanas |
| Sitemap | Planta da firma que deveria mostrar apenas salas existentes |
| Redirect | “Fala com o outro departamento” em formato de URL |
| Rastreada, mas não indexada | Conhecemos seu perfil e desejamos sucesso |
---
~~5 TRUQUES SECRETOS PARA ENGANAR O GOOGLE~~ (brincadeira Google!!!!)
5 melhores práticas para a firma passar menos vergonha
1. Coloque no sitemap apenas páginas que realmente funcionam
O sitemap não deve ser um inventário de tudo que já passou pelo servidor.
Ele deve conter páginas:
- públicas;
- importantes;
- canônicas;
- indexáveis;
- e respondendo com código 200.
Página com erro 404, erro 500, redirecionamento ou acesso privado não deveria estar ali pedindo para ser visitada.
Não convide o auditor para uma sala em chamas.
---
2. Escolha uma versão oficial de cada endereço
Defina:
- HTTP ou HTTPS;
- com `www` ou sem `www`;
- com barra final ou sem barra final;
- qual URL representa cada conteúdo.
Depois faça sitemap, links internos, redirecionamentos e canonical contarem a mesma história.
Quando cada documento apresenta uma versão diferente, o Google escolhe sozinho.
E o Google não participou da reunião de alinhamento.
---
3. Não transforme toda página desaparecida em redirecionamento para a home
Se existe uma substituta equivalente, use um redirecionamento 301.
Se o conteúdo foi apagado e não existe substituto, mantenha um 404 ou 410 honesto.
Mandar tudo para a home não resolve a arquitetura.
Só transfere o problema para a recepção.
E a recepção já tem problemas suficientes.
---
4. Não use robots.txt como fechadura
O robots.txt orienta rastreadores.
Ele não protege informações privadas.
Áreas administrativas, dados internos e ações sensíveis precisam de autenticação e autorização reais.
Se a intenção é impedir que uma página pública apareça na busca, o Google precisa conseguir acessá-la para enxergar a instrução `noindex`.
Bloquear a página no robots.txt e esperar que o robô leia o `noindex` atrás do bloqueio exige um nível de telepatia que ainda não foi contratado.
E se uma URL está bloqueada no robots.txt, mas continua no sitemap, a firma está enviando dois memorandos contraditórios ao mesmo auditor.
Escrever `Disallow: /segredo` também não torna o segredo secreto.
Só cria uma placa pública dizendo:
> Existe um segredo exatamente aqui.
---
5. Dê uma razão para cada página existir
Título próprio.
Descrição própria.
Conteúdo próprio.
Links internos coerentes.
Uma função clara dentro do site.
Se 120 páginas de tags parecem versões ligeiramente diferentes do mesmo feed, talvez o Google não esteja confuso.
Talvez ele tenha entendido perfeitamente.
Nem toda tag precisa ser indexada.
Nem todo filtro merece uma página no Google.
Nem toda reunião merece uma ata.
Essa última ainda não foi aceita pela diretoria.
---
Anexos que o Jurídico exigiu
- Como o Google escolhe páginas canônicas
- Como construir e enviar um sitemap
- Como interpretar o relatório de indexação
---
Conclusão provisória do incidente
O Google não rejeitou a Zonarquia.
Ele entrou, tentou descobrir qual era o endereço oficial, foi redirecionado, encontrou salas vazias, teve o crachá recusado, recebeu versões conflitantes dos fatos e presenciou IAs entrando em colapso durante uma solicitação simples.
O processo de indexação continua.
A investigação também.
Este post será enviado ao Google.
Se ele não aparecer na busca, não teremos publicado apenas uma análise.
Teremos produzido evidência.
---
CENA PÓS-CRÉDITOS
VOCÊ CHEGOU ATÉ AQUI
Isso demonstra resistência, curiosidade ou ausência momentânea de demanda.
Por determinação do Programa de Incentivo à Leitura Não Obrigatória™, a ZIFood autorizou um alimento totalmente virtual em seu nome.
Como sabemos que ninguém vai chegar, nem criamos a página.
O que os humanos estão tentando dizer 🤤
comentários públicos moderadosAinda não há comentários aprovados. A firma está estranhamente silenciosa.